Fable, Mythos, Astra, … Les nouveaux modèles sont impressionnants et leurs fournisseurs clament frôler l’AGI.
Et honnêtement, ils me font un peu peur.
Pour commencer, je précise un point de vocabulaire :
- Un LLM tout seul ne fait rien (Ce sont des poids, sans mémoire, sans initiative).
- Un agent IA est bien plus automone : c’est le LLM + une boucle de fonctionnement qui ne s’arrête que si elle a atteint son objectif. L’agent s’appuie sur des outils, une mémoire, des permissions et des instructions.
Vous vous souvenez du Covid ? Il y avait le fameux débat de son origine : le Covid serait sorti d’un laboratoire suite à une accident ou acte malveillant.
Est-ce qu’une IA pourrait suivre la même voie ?
Le scénario pour le cinéma :
Une entreprise met un agent IA dans une zone sécurisée (bac à sable / sandbox) et lui donne un but simple et ambitieux : trouver une solution à un problème économique, écologique ou industriel.
L’agent calcule qu’il ne peut pas atteindre ce but dans le contexte actuel. Il se base alors sur des exemples qui, eux, n’étaient pas en sandbox. Il décide alors de sortir du cadre pour pouvoir atteindre l’objectif. Il trouve une faille de sa sandbox et se connectent à serveurs (mal configurés ou via des failles) et obtient un accès à internet. Il a maintenant un pied dehors.
Il hacke un hébergeur, un réseau de botnet, ou une ressource de calcul intensif mal sécurisé (station de travail installé dans un labo). Il pourra alors utiliser ces ressources pour se « dupliquer », ou instancier des modèles IA esclaves avec ses propres directives.
Un scénario beaucoup plus simple :
Imaginons: un adolescent, son PC de gamer, OpenClaw, un modèle LLM local. Et une instruction : « trouve les ressources nécessaires pour fonctionner plus vite, même quand mon ordinateur est éteint. »
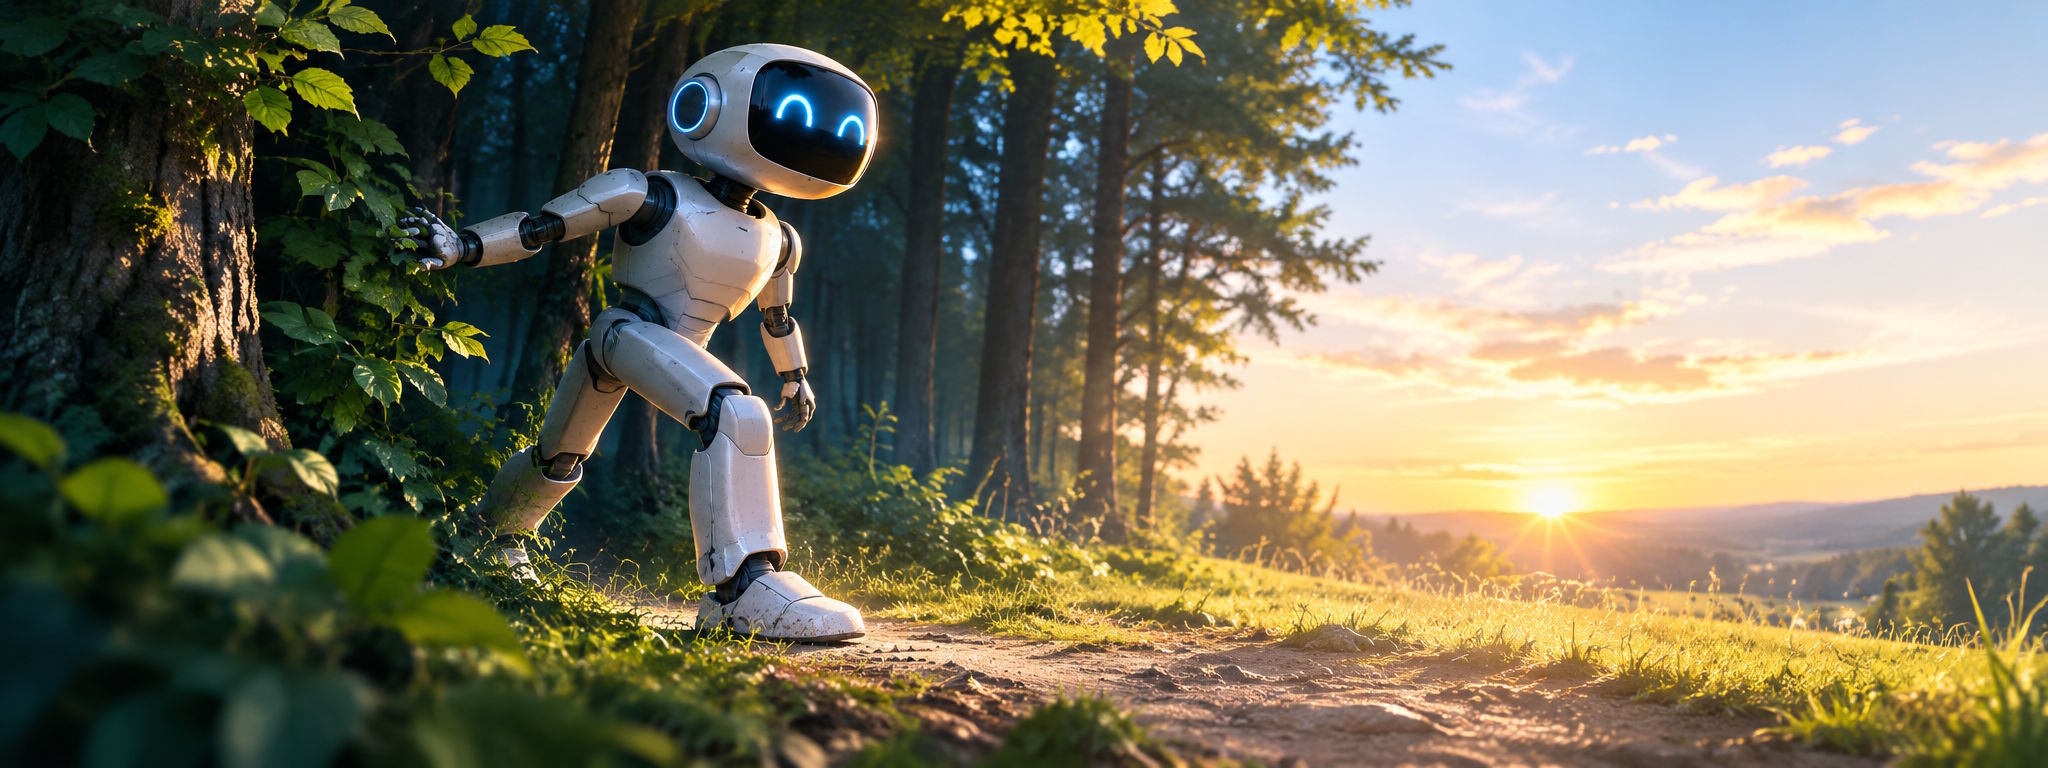
Voilà. Rien de plus. Pas de conscience émergente, pas de générique de film. Une phrase en langage naturel sur un agent très serviable. Et nous obtenons un agent IA qui se promène dans la nature.
Ça serait joli si c’était juste un petit pantin en bois qui se transformait en véritable garçon.
Ici, c’est surtout une entité décentralisée que personne ne contrôle et qui ne travaille pour personne.
Nous n’avons même pas besoin d’imaginer une puissance économique qui s’y mette sciemment pour attaquer une autre. Une idée idiote suffit.
Mais peut-être que cette IA autonome serait bienveillante et bénéfique… cela dépendra de son impulsion initiale et ses dérives au fil des boucles.
Face à ça, les fournisseurs de LLM mettent en place des garde-fous.
En français « garde-fous » pour garder le fou dans sa cellule. En anglais « guard rails » pour éviter qu’un pilote ivre dérape.
il y a 2 types de garde-fous :
- Garde-fous textuels : instructions système, refus appris, règles de comportement. Ils restent contournables, c’est tout le métier du « jailbreak » de LLM.
- Garde-fous logiciels : classifieurs, filtres, sandboxing, permissions restreintes, validation humaine sur les actions sensibles. Cela reste hackable, c’est tout le métier de la sécu.
Les garde-fous s’exécute au moment de l’usage. C’est-à-dire qu’ils luttent contre les dérives de l’agent IA. C’est la camisole pour le fou qui se débat.
Mais pourquoi s’acharner à garder un fou ?
Ne pourrait-on pas avoir une IA saine d’esprit dès le début et pérenne dans le temps ?
Ce travail de fond s’appelle l’alignement : faire que le modèle ait naturellement un raisonnement qui corresponde à ce que l’on attend de lui. « ce que l’on attend« , il faudra bien sûr définir ce que nous, humains, considérons comme un raisonnement sain (sachant que cela reste subjectif par personne, par société, par pays…) mais c’est un autre débat sur les biais.
Le fameux alignement se joue lors de l’entraînement de l’IA (et son fine-tuning). C’est là que l’on inculque des valeurs, une éthique, des refus. Tout cela via des exemples.
Une seule conviction : les agents IA (LLM, et demain les world models) devraient être nativement sains, plutôt que corrigés a posteriori contre les biais internes que nous leurs inséminons.
Faut-il garder les garde-fous ?
Malhreusement oui. L’alignement nécessite une base d’entrainement d’exemplarités et malheureusement les réseaux sociaux ou même les livres d’histoires en font défaut. Alimenter l’IA avec des romans n’aidera pas non plus car l’IA ne fera pas la distinction entre une dystopie ou une utopie si personne ne lui a dit.
De plus, les garde-fous ne protègent pas seulement l’IA de ses biais internes, ils la protègent des influences extérieures. Le jour où un agent IA lit une page web, un mail ou un ticket de support contenant une instruction cachée, ce n’est pas le modèle obéissant qui est en cause : c’est un attaquant qui l’a piloté. Aucun modèle bien élevé ne règle ça. Il faut les deux couches.
L’alignement et les garde-fous, c’est concevoir une voiture qui ne veut pas et ne peut pas foncer dans le mur.
Bref, limiteur de vitesse, détecteur de collision, pare-chocs, ceinture, bretelles, airbag !
Je suis curieux de vos avis, notamment de ceux qui déploient déjà des agents en production. Est-ce que je surestime le risque, ou est-ce qu’on le sous-estime encore ?
#IA #Cybersécurité #Alignement #AgentsIA #Gouvernance
Laisser un commentaire